台湾服务器跑K8s集群:3个跨节点延迟实测与微服务调用链复盘
某跨境电商团队将订单系统拆成12个微服务,部署在台湾机房的6台独立服务器上,用K8s管理。上线后监控显示:跨节点调用P99延迟从同节点的2ms飙到47ms,订单创建接口超时率上升3倍。以下复盘排查与优化过程,供中小运维参考。
一、集群拓扑与节点选型:为什么选了台湾服务器
团队业务面向东南亚和北美西海岸,台湾机房到这两地的物理延迟通常在30-60ms,比新加坡或日本节点更均衡。更重要的是,台湾服务器普遍不限流量或提供大带宽,且多IP站群资源丰富,适合需要多出口的微服务网关。
最终选用6台裸机云,配置分为两类:控制面3台(4核8G起步),工作节点3台(8核16G以上)。存储统一用NVMe SSD,因为etcd对磁盘延迟敏感,HDD会导致leader选举频繁抖动。
选购时重点对比了以下参数:
- CPU主频与核心数:微服务节点建议不低于2.5GHz,核心数按Pod密度估算
- 内存与磁盘:etcd节点必须SSD,工作节点内存至少16G
- 带宽与流量:跨节点通信频繁,建议内网带宽1Gbps起步,公网带宽按业务峰值
- IP数量:网关和Ingress需要独立IP,多IP站群机型更灵活
- 是否支持自定义ISO:部分服务商限制多,影响K8s节点初始化
二、跨节点延迟实测:数据与调用链影响
部署完成后,用ping和qperf测量节点间延迟。同机房内网RTT稳定在0.3-0.8ms,跨机柜或跨网段上升到1.5-3ms。这个数值看似不高,但微服务一次调用链可能经过5-8个服务,累计延迟被放大。
用Jaeger做调用链追踪,发现三个问题:
- 服务发现组件(CoreDNS)默认走公网解析,每次调用增加2-4ms
- 部分Pod没有配置hostNetwork或NodeLocal DNSCache,DNS查询成为瓶颈
- 跨节点通信未启用IPVS,kube-proxy的iptables模式在规则多时延迟抖动明显
三、配置调优与避坑清单
基于这次复盘,整理出可落地的操作步骤:
- 部署前用qperf测所有节点两两之间的TCP延迟和带宽,记录基线
- 安装K8s时指定--pod-network-cidr,避免与机房内网冲突
- CoreDNS副本数至少2个,并开启autopath和cache
- 为延迟敏感的服务设置topologySpreadConstraints,减少跨节点跳数
- 监控etcd的wal_fsync_duration_seconds,超过10ms考虑换NVMe
- 定期用mtr检查节点间路由是否绕行,台湾机房到大陆或海外路由可能变化
选购推荐
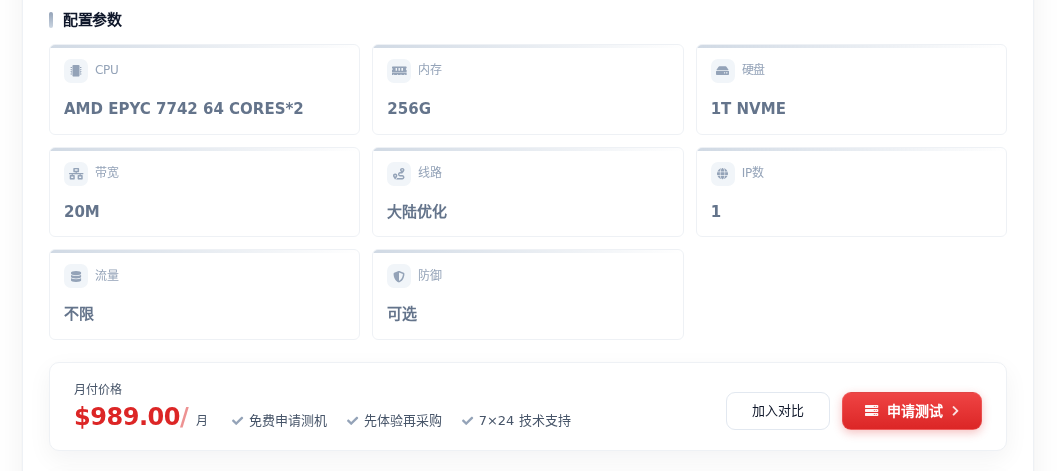
根据上述场景,控制面节点对磁盘IO和稳定性要求高,推荐台湾裸机云 XVI,AMD EPYC 7742 64核*2 / 256G / 1T NVME,NVMe对etcd延迟改善明显,适合作为master或高负载工作节点。预算有限的工作节点可选台湾裸机云 III,E5-2680 / 32G / 1T HDD,价格119元/月,适合部署无状态微服务,但etcd节点务必另配SSD机型。两款均支持真机测试,建议先测内网延迟再决定节点分布。
决策建议
台湾服务器跑K8s的核心矛盾是跨节点延迟放大调用链耗时。中小团队优先做三件事:用NVMe保障etcd稳定、启用NodeLocal DNSCache和IPVS、通过反亲和性把高频调用服务放在同节点。选型时先测试再采购,利用秀米云的真机测试验证网络质量,避免上线后才发现延迟问题。